Chi gestisce server Linux e cluster Proxmox lo sa: il problema non è più la singola vulnerabilità, ma il ritmo con cui ne arrivano.
Il kernel Linux sotto pressione
Nelle ultime settimane i numeri sono cambiati di scala. Il 4 novembre OpenAI ha dichiarato che una pipeline sperimentale, basata su un modello cyber non ancora rilasciato, ha individuato e sfruttato 948 vulnerabilità uniche di escalation di privilegi locale in Linux durante una sessione di ricerca a metà ottobre. Pochi giorni dopo, il Microsoft FORGE Lab ha pubblicato i risultati di una scansione di alcuni sottosistemi del kernel: exploit di privilege escalation funzionanti per otto CVE, e correzioni per 38 segnalazioni già integrate nel mainline. unitemicrosoft
Non è solo ricerca accademica. Un bug rimasto nascosto per quasi cinque anni (CVE-2026-31695) ha ora un exploit pubblico contro un’installazione Fedora 44 Server predefinita. E gli attaccanti concatenano i bug: intrusioni recenti hanno combinato vulnerabilità PHP2Shell con la falla kernel Fragnesia per ottenere root su sistemi PAN-OS. gbhackersgbhackers
Un dettaglio che dovrebbe far riflettere chi si affida solo all’hardening “a checklist”: per CVE-2026-80521 (AF_UNIX) il write-up di kernelCTF descrive un exploit che non usa user namespace, network namespace, io_uring, BPF né userfaultfd, quindi le misure comuni che disattivano queste funzioni non lo bloccano. Qui l’unica difesa pratica è la patch. securityonline
Proxmox: l’hypervisor è un bersaglio ad alto valore
Proxmox VE è ormai la scelta di molte PMI, ed è giusto guardarlo con attenzione, (pure noi in dognet tech abbiamo infrastruttura su proxmox, non è un segreto… ). Nel solo 2026 sono emersi, tra gli altri:
- CVE-2026-51082: una race condition che permette il dirottamento di sessioni VNC tra VM diverse, corretta in pve-manager 9.1.9 e 8.4.19; sentinelone
- CVE-2026-51083: un controllo di accesso errato per cui un utente con privilegi limitati può ottenere password in forma di hash tramite l’API cloudinit/dump; sentinelone
- CVE-2026-53359 (“Januscape”): una use-after-free nello shadow MMU di KVM. Non è un bug dell’interfaccia Proxmox, ma poiché Proxmox VE è esso stesso un host KVM, a essere coinvolto è l’hypervisor, e un’azione dal guest può corrompere la memoria del kernel host; proxmoxpulse
- CVE-2026-98432: un bug nel codice TCP IPv4 del kernel, per cui gli host Proxmox VE e Backup Server con kernel 7.0.14-24-pve o precedenti sono interessati e la correzione è nel kernel 7.0.14-25 e successivi. mrplanb
Alcune sono medie, altre meno gravi, e per Januscape le analisi parlano di patch programmata più che di emergenza, senza sfruttamento noto. Ma il punto non cambia: su un hypervisor, un problema di isolamento colpisce tutte le VM che ospita. proxmoxpulse
Cosa ci insegna tutto questo
Tre cose.
1. Il volume di vulnerabilità non diminuirà. Con strumenti automatici che scoprono bug a questa velocità, la finestra tra scoperta, exploit pubblico e attacco reale si accorcia. Non si può più “aggiornare quando c’è tempo”.
2. Le vulnerabilità locali non sono “meno gravi”. Richiedono un accesso iniziale, ma gli attaccanti quell’accesso lo ottengono (un’applicazione web vulnerabile, credenziali rubate) e poi usano la LPE per arrivare a root. Ridurre ciò che l’attaccante trova dopo il primo ingresso è metà della difesa.
3. Ogni server costruito a mano è un’incognita. Quando dieci macchine nascono da dieci installazioni diverse, nessuno sa davvero quali moduli kernel sono caricati, quali servizi girano, quali configurazioni sono state toccate. Davanti a un advisory come “bloccare il modulo X” non si sa nemmeno quante macchine siano coinvolte.
Baseline e golden image: la risposta strutturale
Qui entra in gioco il lavoro che facciamo in Dognet. Una golden image è una macchina virtuale o un container pre-configurato, hardened e verificato, da cui nascono tutte le istanze di produzione. Una baseline è lo standard documentato che quell’immagine rispetta (CIS Benchmarks livello 1 e 2, NIS2, PCI-DSS, ISO 27001).
Perché conta davanti alle notizie di questi giorni:
- Superficie d’attacco ridotta in partenza. Partiamo da installazioni minimal: meno servizi, meno moduli, meno codice raggiungibile. Quando esce un advisory su un sottosistema del kernel, spesso la macchina non lo carica nemmeno.
- Hardening applicato sempre, non “quando ci si ricorda”. Parametri sysctl, mount option, AppArmor/SELinux in enforcing, SSH e PAM rinforzati sono già nel template, non dipendono dalla memoria di chi installa.
- Patching governabile. Con un’immagine standard si sa cosa gira ovunque. Aggiornare la golden image e ridistribuirla è più rapido e ripetibile che correggere decine di server diversi.
- Verifica continua. Insieme alle immagini consegniamo script di validazione per controllare nel tempo che ogni istanza resti conforme.
- Evidenze per audit. Il compliance mapping verso i framework applicabili è già documentato, utile per NIS2 e ISO 27001.
Sul fronte Proxmox, lo stesso approccio vale per l’host: accesso amministrativo con 2FA, firewall, audit logging, servizi non necessari disabilitati, backup cifrati con Proxmox Backup Server e un piano di disaster recovery con procedure testate.
Una precisazione di onestà: nessuna golden image sostituisce l’aggiornamento del kernel. Contro bug come quelli sopra, la patch (e il riavvio) resta l’unica soluzione. Ma una baseline fa la differenza su tutto il resto: quanto è facile arrivare a quel bug, quanto danno fa l’attaccante dopo, e quanto in fretta si rimette in sicurezza l’intero parco macchine.
Da dove partire
Tre domande da farsi oggi: Sappiamo con precisione quali kernel girano sui nostri host Proxmox e sulle VM? Le nostre macchine nascono tutte da un’immagine standard e verificata? Quanto tempo ci serve per correggere un problema su tutte?
Se la risposta a una di queste è “non lo so”, è il momento di costruire la base. In Dognet possiamo aiutarvi con baseline e golden image per Debian, Ubuntu, Oracle Linux, RHEL e derivate, e con la progettazione e l’hardening del vostro ambiente Proxmox.
Quando l’hardening fa la differenza (e quando no)
Tra maggio e giugno 2026 la famiglia di vulnerabilità “Copy Fail”, “Dirty Frag” e “Fragnesia” ha mostrato bene cosa significa avere sistemi costruiti con attenzione.
Il caso dei moduli che non servono. Copy Fail (CVE-2026-31431) vive nel modulo algif_aead. La mitigazione adottata da molti è stata disattivare quel singolo modulo, che non ha praticamente impatto operativo perché nessun carico di lavoro di hosting in produzione lo usa. Un sistema minimale, in cui i moduli superflui non sono caricati o sono già in blacklist, aveva quindi la porta chiusa prima ancora che la vulnerabilità fosse pubblica. Lo stesso principio emerge dall’avviso di Red Hat su CVE-2026-46331: per OpenShift la gravità è bassa perché il modulo vulnerabile non viene caricato di default. gotekkyredhat
Il caso dei controlli di sistema attivi. Una tabella di test pubblicata da un ricercatore su un detector e PoC per Copy Fail e Dirty Frag mostra risultati diversi per distribuzione. Gli exploit riescono su AlmaLinux 10.1 e Fedora 44 Server, mentre su Ubuntu 26.04 LTS con AppArmor hardened tutte le varianti risultano bloccate. Anche su Ubuntu 24.04 il percorso ESP di Dirty Frag è stato fermato da apparmor_restrict_unprivileged_userns=1. È un esempio concreto: due sistemi con lo stesso bug nel kernel, esito opposto, a seconda di come sono configurati. GitHub – KaraZajac/DIRTYFAIL: Detector + PoC for Linux page-cache write vulnerabilities: Copy Fail (CVE-2026-31431) and Dirty Frag (CVE-2026-43284/43500). Authorized security research only. · GitHub +2
Il caso dei container. Per Dirty Frag, l’analisi di Wiz osserva che l’exploit richiede in genere privilegi elevati come CAP_NET_ADMIN, per cui è meno probabile in ambienti containerizzati hardened, ad esempio Kubernetes con profili seccomp di default. Togliere capability non necessarie ai container (cosa che facciamo nell’hardening Docker/LXC) ha quindi un effetto diretto. wiz
Il caso dei profili AppArmor su misura. Un fornitore di sicurezza sostiene che i workload con un profilo AppArmor default-deny generato dal comportamento reale non avevano mai in elenco le superfici richieste da Dirty Frag, e che quindi risultano non sfruttabili. Il ragionamento è interessante: si autorizza ciò che serve, invece di cercare di vietare ciò che è pericoloso. Tieni presente che è una fonte commerciale e non una verifica indipendente. bifrostsec
Il caso della configurazione dell’hypervisor. Per Januscape su Proxmox, l’esposizione dipende da come sono configurate le VM: il rischio è rilevante in particolare quando la virtualizzazione annidata è esposta alle VM. Chi ha abilitato la nested virtualization solo dove serve, e su guest di cui si fida, ha una superficie molto più piccola. penligent
Ma attenzione: l’hardening non è una scusa per non patchare
Gli stessi episodi insegnano anche il contrario, ed è giusto dirlo nell’articolo per credibilità.
- La mitigazione “tampone” può dare una falsa sicurezza. Dirty Frag è stata progettata, secondo i ricercatori, per funzionare anche sui sistemi dove la mitigazione di Copy Fail (blacklist di algif_aead) era già stata applicata. Chi si era fermato lì risultava ancora vulnerabile. github
- Alcuni controlli non coprono tutto. Le policy AppArmor applicate solo a livello di pod non impediscono lo sfruttamento tramite il percorso RxRPC, quindi la blacklist va applicata a livello di host su ogni nodo. colibrisec
- A volte nessun hardening aiuta. Per CVE-2026-80521, come visto sopra, l’exploit non dipende da user namespace, io_uring o BPF, e la patch resta l’unica difesa pratica.
La lezione è che l’hardening riduce le probabilità e il danno, ma funziona davvero solo insieme a un processo di aggiornamento rapido. E questo è esattamente ciò che una baseline ben progettata rende gestibile: le mitigazioni temporanee (blacklist, sysctl) si distribuiscono su tutto il parco macchine in poche ore, e si rimuovono in modo ordinato quando arriva la patch.
E la sentinesuite?
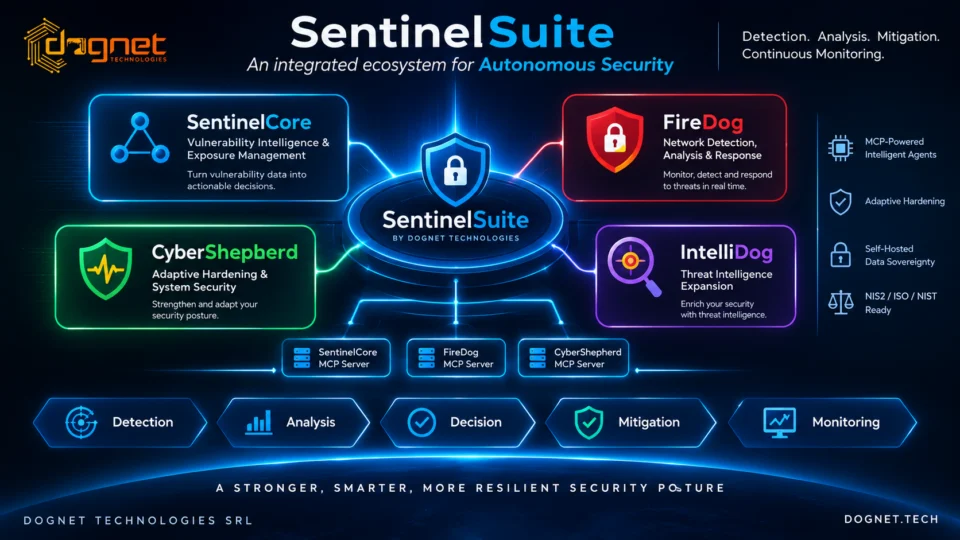
Almeno 2 prodotti della sentinesuite in uno scenario come quello che abbiamo visto avrebbero potuto essere di enorme aiuto:
- Sentinelcore: con il suo motore di riprioritizzazione basato sul rischio e l’assegnazione al team/utente più adatto alla risoluzione della vulnerabilità appena rilevata aiuta a diminuire il tempo di esposizione dal rilevamento alla remediation
- Cybershepherd: grazie al monitoraggio e alla feature di “hardening adattivo” con apparmor avrebbe mitigato se non addirittura vietato il danno provocato dallo sfruttamento della suddetta vulnerabilità
- Nella versione PRO i software si integrano, non solo tramite server MCP e aiuto agentico, ma proprio si scambiano informazioni e condividono dati utili al fine di accelerale il processo di contenimento e mitigazione fino alla risoluzione della falla.